公众号文章下载
官方脚本
可调用节点
v2.1.0
微信公众号文章批量下载 | 支持单篇/批量/合集一键采集下载,保存为 HTML/Markdown/PDF/Word/纯文本,自动下载配图,可选下载视频与音频,自动识别验证码页防封禁
脚本能力
直接启动支持
右键启动支持
快捷键启动支持
超级复制启动不支持
定时任务不支持
可被其他脚本调用是
依赖其他脚本否
图形化启动界面支持
把微信公众号文章(单篇 / 批量 / 合集)一键保存到本地,支持 HTML / Markdown / 纯文本 / PDF / Word,自动下载配图,可选下载视频与音频。抓取自动识别验证码页并退避重试,省心防封。
核心特性
- 多格式保存:HTML(原样式,图片 base64 内嵌,离线可看、转发不丢图)、Markdown(YAML frontmatter + 本地相对图片,Obsidian 友好)、纯文本、PDF(Edge 无头打印)、Word(.docx)
- 合集批量下载:粘贴合集链接(含
__biz与album_id)自动分页拉全,逐篇落盘并生成index.md目录 - 链接清单批量:粘贴一段含链接的文字、每行一个 URL,或提供 .txt 链接清单文件均可
- 配图 + 音视频:正文图片自动下载(规避「此图片来自微信公众平台」占位图),可选下载文章内视频(最高清)与音频
- 防验证码 / 防封:识别验证码页与已删除死链,指数退避重试;请求间隔带随机抖动
- 按公众号归档:
公众号/日期_标题/目录结构,同标题自动加序号不覆盖 - 触发灵活:盒子卡片、快捷键、资源管理器右键背景均可启动
脚本演示
安装方法
本脚本的运行环境、依赖组件及图形化窗口均依赖"不忙脚本盒子",建议仅通过盒子安装和使用本脚本。
前置条件:安装好 不忙脚本盒子
- 打开盒子 → 脚本市场 → 搜索 「公众号文章下载」
- 点击「安装」
使用方式
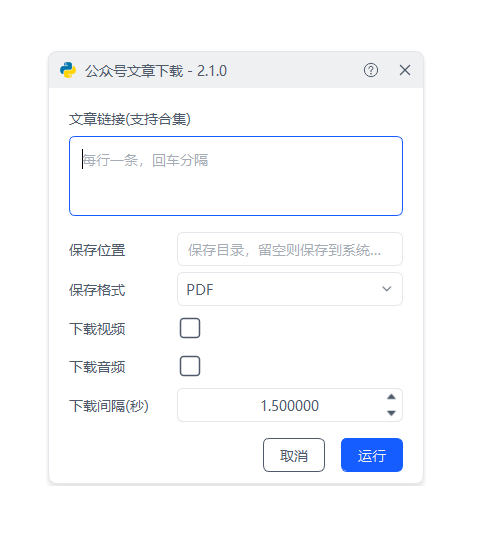
启动后会弹出设置窗口,填好链接与选项,点「执行」即可。
- 卡片运行
- 在盒子里点击脚本卡片,弹出启动窗口
- 在「文章链接」框粘贴链接(每行一条,或一整段含链接的文字,或一个合集链接)
- 选择保存格式与选项,点「执行」
- 右键启动
- 在文件夹空白处右键 → 选择「公众号文章下载」
- 弹出启动窗口,粘贴链接后点「执行」
- 快捷键启动
- 为脚本设置全局快捷键(盒子「热键管理」页),按下快捷键后填写链接执行
参数说明
| 参数 | 说明 |
|---|---|
| 文章链接 | 每行一条文章/合集链接,或粘贴含链接的文字,也支持 .txt 链接清单文件路径 |
| 保存位置 | 留空则保存到系统下载目录「公众号文章下载」 |
| 保存格式 | 下拉框单选:网页 HTML / Markdown / 纯文本 / PDF / Word |
| 下载视频 | 下载文章内视频(最高清,存到 media 子目录) |
| 下载音频 | 下载文章内音频(存到 media 子目录) |
| 下载间隔(秒) | 每篇之间的请求间隔(含随机抖动,防限流) |
文章配图、每篇单独子文件夹、HTML 图片内嵌均默认开启,无需配置。
💡 使用提示
- PDF 依赖系统 Edge:未检测到 Edge 时会提示改装 Edge,或换其他格式
- 合集链接:形如
https://mp.weixin.qq.com/mp/appmsgalbum?__biz=xx==&album_id=NNN(含__biz与album_id)会自动进入合集模式 - 链接被验证码拦截:脚本会自动退避重试;仍失败会单独报错并继续下一篇
- 视频号 / 腾讯视频:无法免证书下载,Markdown/HTML 里会留占位说明
- 批量下载建议间隔 ≥1.5 秒,避免被限流
输出目录结构
公众号文章下载/
├── <公众号>/<YYYY-MM-DD>_<标题>/
│   ├── <标题>.md / .html / .pdf / .txt / .docx
│   ├── assets/      # 正文图片
│   └── media/       # 视频、音频(开启时)
└── <公众号>/合集_<合集名>/
    ├── index.md     # 合集目录
    └── 01_<标题>/ ... 02_<标题>/ ...
🖥️ 环境要求
| 项目 | 要求 |
|---|---|
| 操作系统 | Windows 10+(64 位) |
| 运行环境 | Python 3.8+(盒子自动安装)、Edge/Chrome(PDF 格式需要) |
节点脚本(开发者阅读)
本脚本声明为节点,可被其他脚本通过盒子 /api/link 联动调用(无人值守,不弹窗口)。调用方需在请求里传 data.links_text(文章/合集链接数组)与 params。
curl -X POST http://127.0.0.1:9527/api/link \
  -H "Content-Type: application/json" \
  -d '{
    "script_id": "28a9b661-148e-4b4e-bf61-b79586f84566",
    "data": { "links_text": ["https://mp.weixin.qq.com/s/xxxx"] },
    "params": { "format": "md", "delay": 1.5 }
  }'
返回的业务键(信封顶层):
| 键 | 类型 | 说明 |
|---|---|---|
output_dir |
str | 本次下载的保存根目录绝对路径 |
ok |
str | 成功下载的链接数 |
fail |
str | 下载失败的链接数 |
code = 0 表示有文章成功下载;全部失败时 code = 1。
📄 开源许可
本脚本的抓取健壮性(验证码识别/URL 规范化/合集分页)、图片防坑、音视频抽取与下载、Markdown frontmatter 导出等能力,部分适配自 Echo-wechat-skill(MIT License)。感谢原作者开源。
本脚本已声明为节点,可被其他脚本通过「不忙脚本盒子」机制调用。完整配置见下方 TOML,其他脚本若需调用请严格按此配置构造请求。
bm-scripts-box-rc.toml
[bmscriptsbox]

[bmscriptsbox.info]
id = "28a9b661-148e-4b4e-bf61-b79586f84566"
name = "公众号文章下载"
desc = "微信公众号文章批量下载 | 支持单篇/批量/合集一键采集下载,保存为 HTML/Markdown/PDF/Word/纯文本,自动下载配图,可选下载视频与音频,自动识别验证码页防封禁"
version = "2.1.0"

[bmscriptsbox.runtime]
language = "python"
language_version = ">=3.8"
entry = "main.py"
terminal = "always"

[bmscriptsbox.triggers.context_menu]
enabled = true
targets = ["background"]

[bmscriptsbox.triggers.shortcut]
enabled = true
input_type = ""

[[bmscriptsbox.inputs]]
name = "links_text"
label = "文章链接(支持合集)"
type = "list"
description = "每行一条公众号文章链接或合集链接,或粘贴一段含链接的文字,也支持 .txt 链接清单文件路径"

[[bmscriptsbox.params]]
name = "output_dir"
label = "保存位置"
type = "str"
default = ""
description = "保存目录,留空则保存到系统下载目录「公众号文章下载」"

[[bmscriptsbox.params]]
name = "format"
label = "保存格式"
type = "str"
default = "html"
choices = ["html", "md", "txt", "pdf", "docx"]
choice_labels = { html = "网页 HTML", md = "Markdown", txt = "纯文本", pdf = "PDF", docx = "Word" }
description = "输出格式:HTML(原样式,内嵌图)/ Markdown(Obsidian 友好)/ 纯文本 / PDF(Edge 打印)/ Word"

[[bmscriptsbox.params]]
name = "download_video"
label = "下载视频"
type = "bool"
default = false
description = "下载文章内视频(最高清,存到 media 子目录)"

[[bmscriptsbox.params]]
name = "download_audio"
label = "下载音频"
type = "bool"
default = false
description = "下载文章内音频(存到 media 子目录)"

[[bmscriptsbox.params]]
name = "delay"
label = "下载间隔(秒)"
type = "float"
default = 1.5
description = "每篇之间的请求间隔(含随机抖动,防限流)"

[bmscriptsbox.params_form]
enabled = true

# 声明为节点:可被其他脚本通过 /api/link 联动调用
[bmscriptsbox.node]
enabled = true

[[bmscriptsbox.outputs]]
name = "output_dir"
type = "str"
description = "本次下载的保存根目录绝对路径"

[[bmscriptsbox.outputs]]
name = "ok"
type = "str"
description = "成功下载的链接数(字符串)"

[[bmscriptsbox.outputs]]
name = "fail"
type = "str"
description = "下载失败的链接数(字符串)"
评论